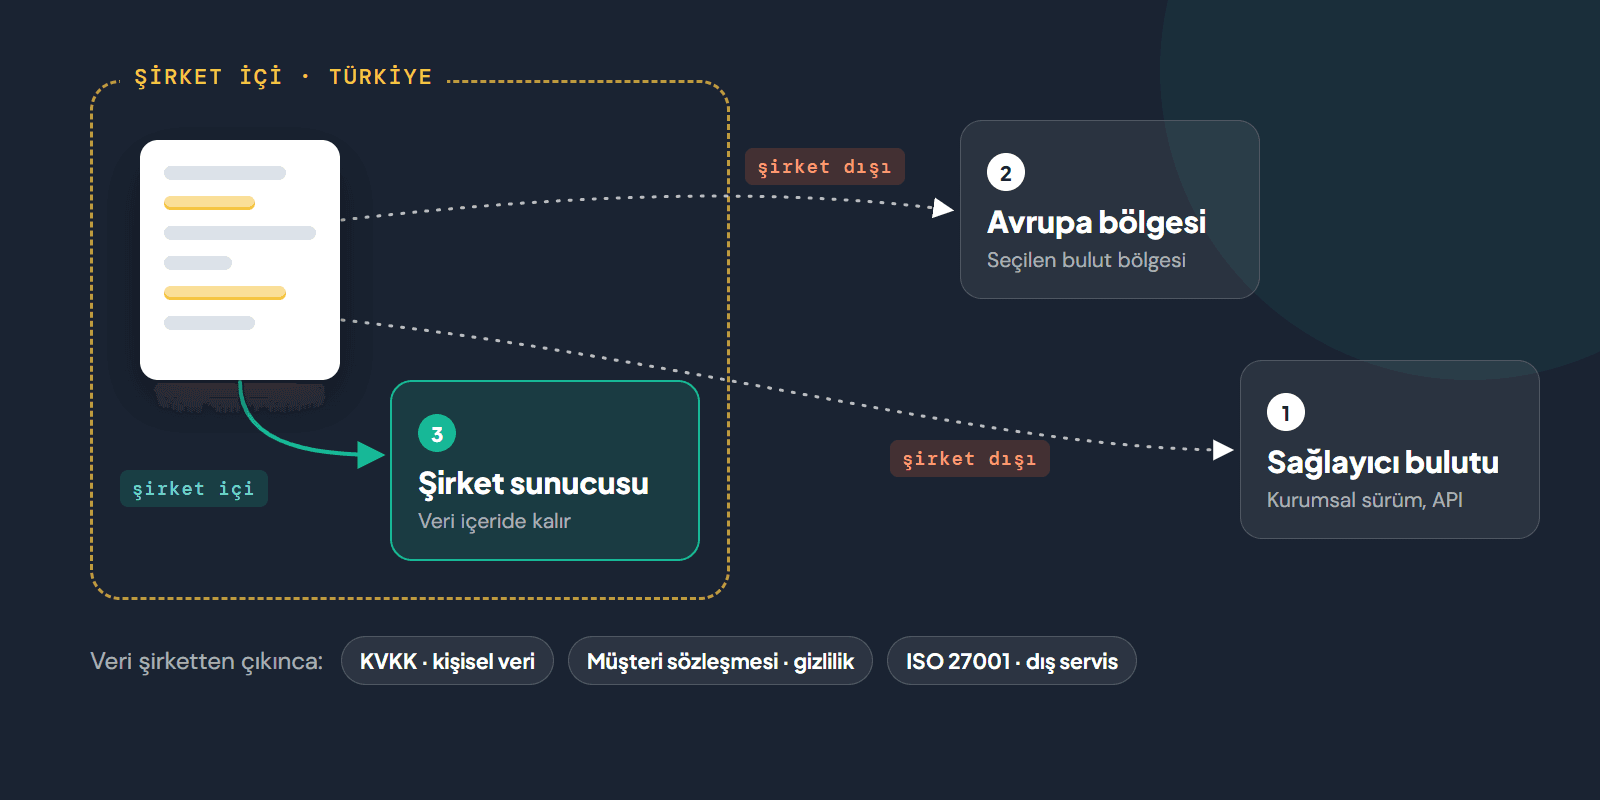
Kısa cevap: Yerel yapay zekâ, yani modelin şirketin kendi sunucusunda çalışması, üç koşul birlikte varsa mantıklıdır: verinin dışarı çıkmaması yazılı bir kurala (mevzuat ya da müşteri sözleşmesi) dayanıyorsa, iş dar ve tekrarlı ise (belge sınıflandırma, alan çıkarma, özetleme gibi) ve sistemi kimin işleteceği belliyse (kendi ekibiniz ya da bir iş ortağı). İlk iki koşuldan biri eksikse, kurumsal bulut sürümleri çoğu zaman daha iyi sonuç verir ve daha az maliyet çıkarır.
Bu yazı bilgilendirme amaçlıdır, hukuki görüş değildir. Kendi durumunuz için hukuk danışmanınızla birlikte değerlendirin.
"Yerel" Ne Demek? Üç Seçenek
"Verimiz dışarı çıkmasın" denildiğinde genellikle üç farklı kurulum aynı cümleye sığdırılır. Aralarındaki fark, verinin nerede işlendiğidir:
| Seçenek | Veri nerede işlenir? | Örnek |
|---|---|---|
| 1. Sağlayıcının bulutu | Sağlayıcının yurt dışındaki altyapısında | Claude veya ChatGPT'nin kurumsal sürümleri ve API'leri |
| 2. Bölgesi seçilen bulut | Seçtiğiniz bölgede, ama yine yurt dışında | Claude'u Amazon Bedrock üzerinden bir Avrupa bölgesinde çalıştırmak |
| 3. Şirket sunucusu (yerel) | Sizin sunucunuzda, şirketin içinde | OpenAI'ın açık ağırlıklı modeli gpt-oss'u kendi donanımınızda çalıştırmak |
Bu yazının konusu üçüncü seçenek; İngilizce kaynaklarda kurum içi (on-premise) kurulum ya da yerel LLM (local LLM) olarak geçer. Ama karar, üçü yan yana konmadan verilemez.
İki sağlayıcının durumu farklı:
- Claude: Anthropic, Claude modellerini şirketin kendi sunucusuna kurulacak şekilde (self-hosted) sunmuyor. Bu nedenle şirket içi kurulum senaryosunda Claude doğrudan bir seçenek değil. Bölge kontrolü ise kanala göre değişiyor: Anthropic'in kendi API'sinde bugün iki seçenek var (yalnızca ABD ya da küresel). Amazon Bedrock ve Google Cloud'da bölgeyi kullandığınız uç nokta belirliyor1. Amazon Bedrock'ta Claude için Avrupa'da birçok bölge var, Türkiye'de yok2.
- OpenAI, Ağustos 2025'te gpt-oss adlı iki açık ağırlıklı (open-weight) model yayımladı. Bunlar Apache 2.0 lisansıyla indirilip şirketin kendi donanımında çalıştırılabiliyor3.
KVKK Açısından Ne Değişir?
Şirkette yapay zekâ ve KVKK yazımızda anlattığımız gibi, asıl düğüm verinin yurt dışına çıkmasıdır: KVKK'nın Üretken Yapay Zekâ Rehberi, yurt dışındaki bir hizmet sağlayıcı üzerinden kişisel veri işlendiğinde aktarımın Kanun'un 9. maddesine uygun yapılması gerektiğini söylüyor4.
Buna göre üç seçeneğin KVKK karşılığı şöyledir:
- 1 ve 2. seçenek: Veri yurt dışında işlenir. Bölge seçmek verinin hangi ülkede işlendiğini değiştirir, ama Türkiye dışında olduğu sürece 9. madde sorusu ortadan kalkmaz.
- 3. seçenek: Sunucu Türkiye'deyse yurt dışı aktarım sorusu kural olarak ortaya çıkmaz. KVKK'nın diğer yükümlülükleri ise her kurulumda olduğu gibi geçerlidir; veri güvenliği tedbirleri bunların başında gelir5.
Ne Zaman Mantıklı?
1. Veri dışarı çıkamıyorsa, ve bu yazılıysa. Müşteri sözleşmesinde verinin üçüncü taraf servislere verilemeyeceği açıkça yazıyorsa, ya da sektör mevzuatı bunu gerektiriyorsa, 1. ve 2. seçenekler zaten masada değildir. Burada önemli olan "yazılı" kelimesidir. "Bizde veri dışarı çıkmaz" bir tercih olabilir; tercih ise yeniden değerlendirilebilir.
2. İş dar ve tekrarlıysa. Gelen talepleri sınıflandırmak, belgelerden belirli alanları çıkarmak, standart metinleri özetlemek gibi işlerde açık ağırlıklı modeller genellikle yeterlidir. Her gün aynı türden yüzlerce belge işleniyorsa, kullanım başına ödeme yapılan bulut servislerine göre maliyet hesabı da değişebilir.
3. İşletme sorumluluğu netse. Yerel model bir kez kurulup unutulan bir yazılım değildir. Donanım, model güncellemeleri, güvenlik yamaları, erişim yetkileri ve izleme sürekli bir iştir. Bu işi yapacak ekibin şirket içinde olması gerekmez. Tek bir kullanım senaryosu için bu alanda uzman istihdam etmek, kurulumu ve işletmeyi bir iş ortağına vermekten daha pahalı olabilir. Önemli olan, sorumluluğun baştan birine verilmiş olmasıdır. Sahibi olmayan bir model, kurulduğu gün eskimeye başlar.
🛠️Kurulumu ve işletmeyi de üstlenebiliriz: model, güncellemeler ve güvenlik tek bir sorumluda olur.
Bunu KonuşalımNe Zaman Mantıklı Değil?
1. Kural aslında bir alışkanlıksa. "Veri dışarı çıkmasın" cümlesinin kaynağı mevzuat mı, sözleşme mi, yoksa yazılı olmayan bir tercih mi? Bunu nereden başlanacağını anlattığımız yazıda ayrıca ele aldık. Kaynak netleşmeden yerel modele yatırım yapmak, var olmayan bir kısıt için para harcamak olabilir.
2. Veri henüz sınıflandırılmamışsa. Hangi verinin hassas olduğu tanımlı değilse, "her şey yerelde kalsın" en kolay ama en pahalı cevaptır. Doğru sıra, model seçmeden önce veri envanterini çıkarmak ve hangi verinin hangi sisteme girebileceğini belirlemektir.
3. En iyi muhakeme gerekiyorsa. Açık ağırlıklı modeller hızla gelişiyor, ama sağlayıcıların en güncel bulut modelleriyle aynı yerde değiller. OpenAI'ın kendi açıklamasına göre gpt-oss-120b, temel muhakeme testlerinde kendi o4-mini modeliyle aynı düzeyde6. Bunlar OpenAI'ın kendi test sonuçları; bağımsız ölçümler işe göre farklılık gösterebilir. Uzun sözleşme analizi, çok adımlı planlama ya da karmaşık soru-cevap gibi işlerde aradaki fark sonuca yansır.
4. Hacim düşük ya da dalgalıysa. gpt-oss-120b tek bir 80 GB'lık veri merkezi GPU'suna (örneğin NVIDIA H100) sığacak şekilde tasarlandı. Küçük model gpt-oss-20b ise 16 GB bellekle çalışabiliyor3. Pratik kural şudur: Düşük ve dalgalı hacimde, kullandığınız kadar ödediğiniz bulut genelde avantajlıdır. Yüksek, öngörülebilir ve tekrarlı hacimde ise yerel kurulumun sabit maliyeti zamanla avantaja dönüşebilir.
Karar Vermeden Önce 5 Soru
- Verinin dışarı çıkmasını engelleyen kural nerede yazıyor?
- Yapay zekânın yapacağı iş dar ve tekrarlı mı, yoksa geniş muhakeme mi gerektiriyor?
- Bu iş ayda kaç kez yapılıyor?
- Modeli, güncellemeleri ve güvenliği kim işletecek: kendi ekibiniz mi, bir iş ortağı mı?
- Hangi verinin hangi sisteme girebileceği tanımlı mı?
İlk iki sorunun cevabı netleşmeden donanım konuşmak erkendir. Model seçimi en sona kalır; önce veri envanteri ve sınıflandırma, sonra da hangi işte yapay zekânın gerçekten karşılığı olduğu netleşmelidir. AI Discovery hizmetimiz bu soruyla başlar: kurumsal veriyi dışarı çıkarmadan, hangi süreçte yapay zekânın değer ürettiğini ve o süreç için hangi kurulumun doğru olduğunu birlikte buluruz.
Kaynaklar
Numaralar metindeki işaretlere karşılık gelir. Sağlayıcıların bölge ve ürün seçenekleri sık değişir; bilgiler 13 Ekim 2026 itibarıyladır.
- Anthropic, Data residency belgesi. Claude API'de çıkarımın (inference) nerede çalışacağı "inference_geo" ayarıyla seçiliyor ve bugün yalnızca iki değer var: "global" (varsayılan) ve "us" (yalnızca ABD). Belgeye göre Amazon Bedrock ve Google Cloud'da bölge, kullanılan uç nokta veya çıkarım profiliyle belirleniyor. ↩
- AWS, Amazon Bedrock bölge uyumluluğu sayfası. Claude modelleri Frankfurt, Zürih, Stockholm, Milano, İspanya, İrlanda, Londra ve Paris bölgelerinden kullanılabiliyor. Listede Türkiye'de bir bölge yok (13 Ekim 2026 kontrolü). ↩
- OpenAI, gpt-oss-120b model kartı (Hugging Face). Lisans: Apache 2.0. gpt-oss-120b "tek bir 80 GB GPU'ya (NVIDIA H100 veya AMD MI300X gibi)" sığacak şekilde; gpt-oss-20b "16 GB bellek içinde" çalışacak şekilde tasarlandı. Model kartına göre 120b "üretim ve yüksek muhakeme gerektiren genel amaçlı kullanım", 20b "düşük gecikme, yerel veya özel kullanım" içindir. ↩ ↩
- KVKK, Üretken Yapay Zekâ ve Kişisel Verilerin Korunması Rehberi (15 Soruda), Kasım 2025, Soru 10 (s. 48). Türkiye'deki veri sorumlularının yurt dışında yerleşik hizmet sağlayıcılar üzerinden yapay zekâ kullanması ve kişisel verinin bu yolla yurt dışına çıkması hâlinde aktarımın Kanun'un 9. maddesi ve yurt dışına aktarım yönetmeliğine uygun yapılması gerekiyor. ↩
- 6698 sayılı Kanun, madde 12; Rehber, Soru 13 (s. 54–56). Veri sorumlusu, kişisel verilerin hukuka aykırı işlenmesini ve erişilmesini önlemek ve muhafazasını sağlamak için gerekli her türlü teknik ve idari tedbiri almak zorundadır. Rehber; çok faktörlü kimlik doğrulama, yama yönetimi, işlem kayıtlarının güvenli saklanması ve istem enjeksiyonu (prompt injection) gibi yapay zekâya özgü zafiyetlere karşı kontrolleri örnek tedbirler arasında sayıyor. ↩
- OpenAI'ın gpt-oss duyurusu (5 Ağustos 2025), InfoQ aktarımıyla: gpt-oss-120b temel muhakeme testlerinde o4-mini ile aynı düzeyde ya da üstünde, gpt-oss-20b ise o3-mini düzeyinde. Bunlar OpenAI'ın kendi test sonuçlarıdır; bağımsız ölçümler işe göre farklılık gösterebilir. ↩
🗓️Ücretsiz 30 dakikalık görüşmede size özel bir yol haritası çıkaralım.
Görüşme Planla🧭Verinizi dışarı çıkarmadan yapay zekânın hangi işinizde karşılığı olduğunu birlikte bulalım.
AI Discovery Hakkında KonuşalımBu yazıyı faydalı buldunuz mu? Ekibinizle paylaşın.